钱花在想清楚之前。
一个月,5.79B token,795 次提交,十六个功能节点。上一次记的账是七个月,这一次只算一个月。两本账摆在一起有意义,相加没有意义:边界换了。这篇把两件事分开记:钱花在哪,行数落在哪。
这本账最反直觉的一页,是最高的一根柱子和最低的一根柱子不在同一件事上:token 的峰值出现在还没写代码的那几天。
两本账不能相加
同一个仓库,两次记账,边界不一样。
九月我记过一本账:七个月、七十四亿 token、十一个工具、三条产品线。那本账能成立,只因为它答一个问题:一条业务意图从零到量产,一共花了多少上下文。这一本只回答另一个问题,一个月里这台机器的时间都花在什么地方。
两份读数并排放着,不做除法。七十四亿除以七,看起来像个漂亮的月均,实际什么也没说:那七个月里有立项、有废掉的尝试、有两次换机器。这个月也没什么可比性:一条镜像线、一个工作模式、一次安卓发版同时压在肩上。边界一换,平均数便只是平均数。
| 口径 | 2026-09-24 → 10-24 | 说明 |
|---|---|---|
| 窗口 | 31 天(有会话 27 天) | 9 月 26 日至 29 日没有会话 |
| 会话 / 提问 | 91 个 / 1,346 次 | 同一台机器、同一个工作目录树 |
| 输入(非缓存) | 132.1M | 新读进去的东西 |
| 模型输出 | 20.18M | 真正写出来的字,另含推理 9.47M |
| 缓存重读 | 5.57B | 占处理总量 96.3% |
| 处理总量 | 5.79B | 输入 + 输出 + 缓存重读 |
| 记账成本 | $86.8 | 每条消息自带的计价,不等于账单 |
读者最锋利的一刀大概是这一句:把重读算进总量,就是在虚报。这话对。表里便给了三行,谁想用哪个口径就用哪个。想谈花费,看第三行和第五行;想谈产出,看第四行和下一节。只有一行会被误读,就是那个五十七亿九千万。
5.79B 里,132.1M 是真正新读入的输入,20.18M 是模型写出来的输出,5.57B 是每一轮把之前的上下文重新读一遍的缓存。三者的记录单位相同,工程含义完全不同。本文此后谈钱用总量,谈活干得多少用输出。
账本不能相减,只能并置。
峰值出现在立项日
最高的柱子底下,通常没有一行代码被提交。
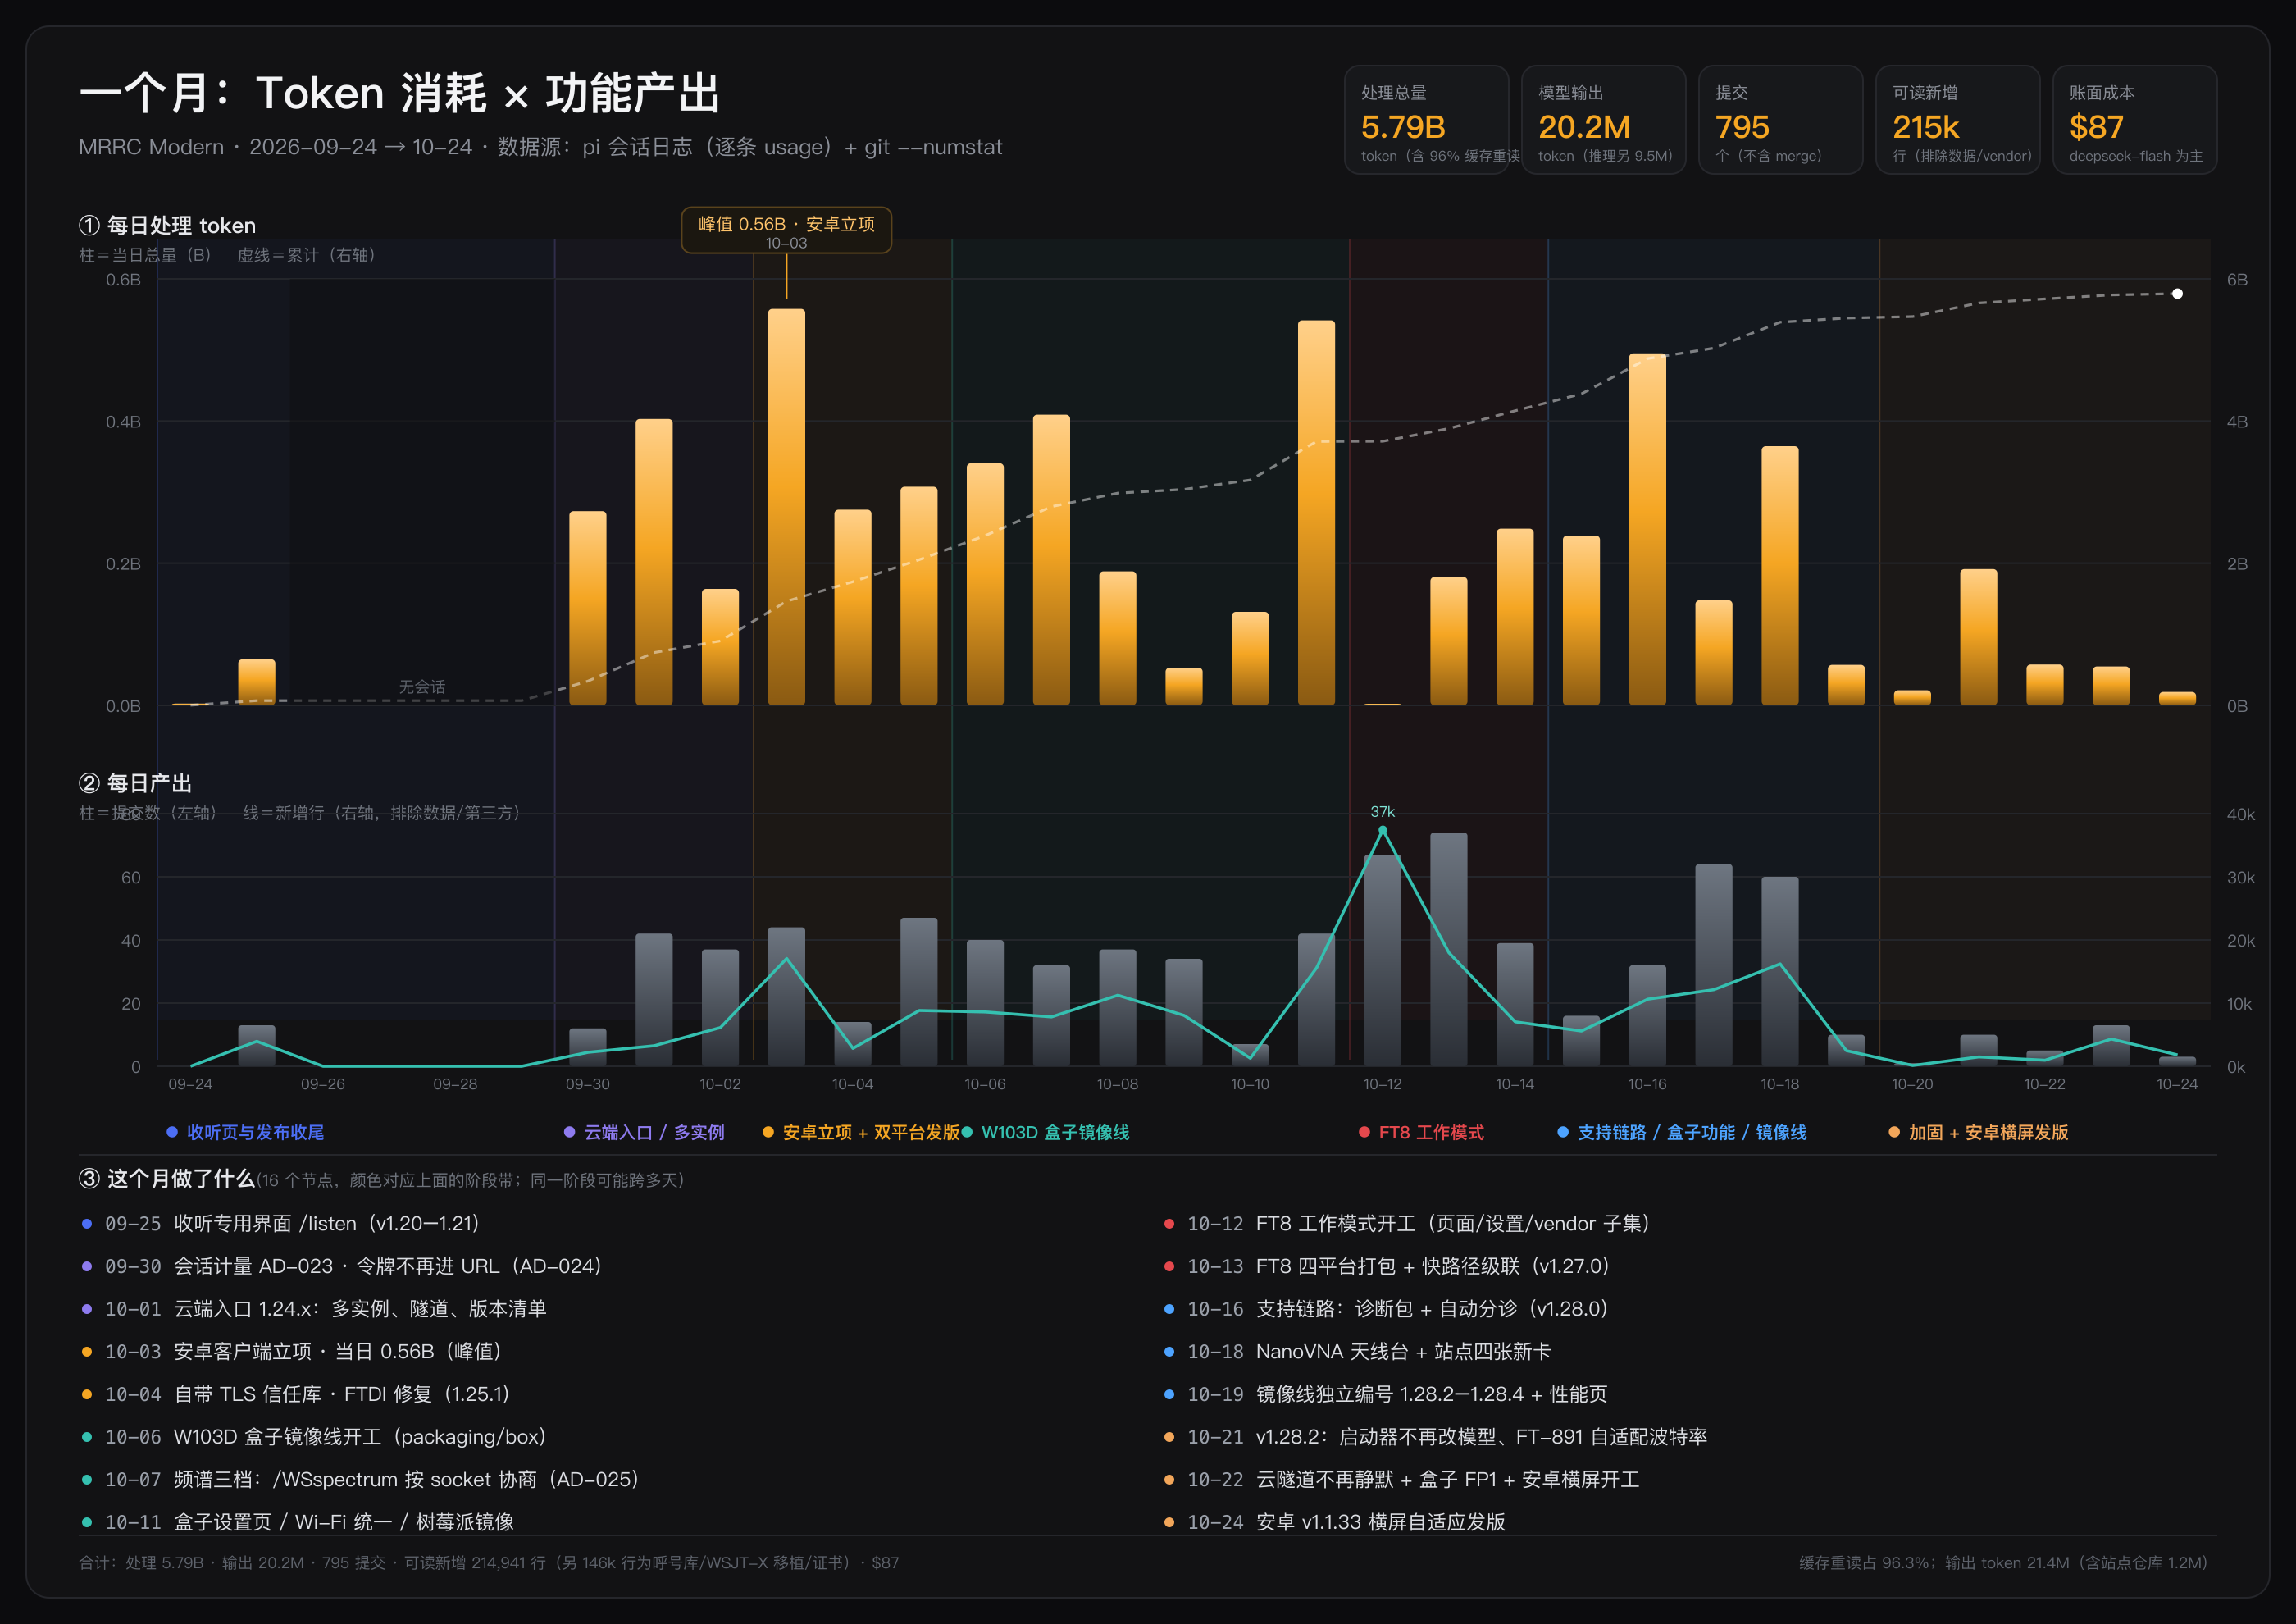
把每天的处理量画成柱状图,四个峰立得很清楚。它们没有长在提交最多的日子上,而长在那些「决定接下来做什么」的日子里。
| 日期 | 处理量 | 当天在做的事 |
|---|---|---|
| 09-30 | 273M | 远程接入统一设计文档 v2.0(单会话 601M) |
| 10-03 | 558M | 安卓客户端立项,首版当天开写 |
| 10-11 | 542M | 树莓派镜像 + 盒子设置页的 Wi-Fi 状态机 |
| 10-16 | 495M | 支持链路:诊断包、自动分诊、v1.28.0 |
10-03 那天最典型。当天提交数在三十天里排不进前十,但它同时是安卓客户端的第一天。此后再没有哪一天的 token 能接近它,而那一天的产出只有几份设计和一个空工程。
写代码的时候,上下文是稳定的,模型只需要在既有结构里追加;决定做什么的时候,要把已有的规格、真机现象、几条失败路线一起读进来,反复比对。前者省,后者贵。峰值便落在立项、改设计、拆根因的日子,不在提交最多的日子。
钱花在想清楚之前。
行数落在想清楚之后
同样一个月,提交与行数的尖峰在另一侧。
三十一天里,795 次提交、新增 361,293 行、删除 28,629 行。平均每天二十六次提交,看起来像流水线,实际上不是:尖峰集中在两天,10-12 新增 37,432 行(FT8 页面移植,一天三十七次提交),10-13 交出了 74 次提交(四平台打包与快路径级联)。
先去掉不该算的行。新增的三十六万里,十万行是呼号库 ALLCALL7.TXT,四万六千行是从 WSJT-X 移植进来的 DSP 子集与 Boost 头文件,另有几千行是证书与二进制资产。这些行都要进仓库,但没有一行是人写的,也没有一行是模型写的。扣掉之后,可读新增 214,941 行。
| 类别 | 新增行 | 占比 |
|---|---|---|
| 手写代码(Python / Kotlin / JS / C) | 70,827 | 33% |
| 文档与设计 | 62,516 | 29% |
| 测试 | 45,804 | 21% |
| 站点页面 | 33,914 | 17% |
这张表值得多看一秒。文档与测试加起来超过一半。也就是说,这个月真正被写下来的东西,多数不是功能,而是「让下一次能快起来」的东西:规格、判定、门槛。
拿这批数字做换算很容易:每提交约 25k 输出 token,每可读新增行约 94 个输出 token。换算本身没问题,但一旦拿它当目标,第一个被优化掉的恰好是测试和文档:最容易被删,也最难在短期内看出少了什么。行数是产出的影子,不是产出。
同一个道理反过来也成立:想判断这一个月有没有长进,别数行数,去数那些删除的行。28,629 行删除里,藏着三轮返工、一次架构回头和无数条被替换掉的死代码。
九成七是重读
这个比例不是浪费,是上下文规模的样子。
5.57B 的缓存重读,占总量 96.3%。第一次看到这个数会想,是不是哪里写错了。没有。它与会话的工作方式有关:每一轮请求,模型都要把之前所有消息再读一遍,才有办法接着往下写。读的单价低,计数照记。
成本的主变量倒不是「说了多少话」,是「上下文有多长」。一次会话从干净的十万 token 涨到五十万,后面每一轮的价钱都跟着涨。本月 91 个会话平均每个处理 63.6M,最长的那个单会话 601M,一整晚都在同一份设计文档上来回改。
既然贵在上下文长度,省的办法就不是把话说短,而是让下一个会话不必背着上一个会话走路。规格写进文件、判定写成测试、坑记进守卫,新会话从干净上下文开始,只读需要的那几页。本月文档与测试占可读新增的一半以上,从账上看是支出,从下一本账看是折扣。
缓存重读不是记忆,是每一轮把上下文再念一遍。
十六个脚印
把数字换成人看得懂的东西,才谈得上复盘。
下面这张图把三样东西叠在一个时间轴上:每天的 token(柱)、每天的提交与新增行(第二组)、以及这个月真正落地的十六个节点。阶段底色标的是那几天的主线。
收听页与双平台发版
9 月下旬,收听专用界面与两次桌面发布收尾。这一段的价值不在代码量,在于把「只收听」变成一个可交付的角色,为后来的公开入口留了口子。
盒子镜像线
10 月上旬,一台一百多元的电视盒子变成能发货的服务端。镜像、Wi-Fi 预置、首启探测、验收十二项,这条线后来独立编号,与桌面线分开走。
FT8 工作模式
10 月 12 日到 13 日,工作模式从计划走到四平台打包,两天三十七万行中的大头在这里。快路径加级联解耦在当天定型,随后两周只在修边角。
安卓与横屏
10 月 3 日立项,10 月 24 日发出 1.1.33:一天之内定下横屏的五个取舍,从设计到签名包,三个提交、约一千一百行,功能一个没少。
没量到的也是账
一篇文章的可信度,取决于它敢不敢列出自己没有的东西。
上面所有数字都可以按同样的命令行重算。它们的边界却必须说清楚,否则下一篇文章会拿这本账去支撑它撑不住的话。
只统计了这一台机器上的一个工作目录树:别的工具、另一台机器、纯手工编辑的提交都不在里面。不含人力时间,也换算不出「省了几个人月」。没有比较模型,比较不了:每个模型跑的活儿不一样。成本是记账值,不等于账单。最重要的:这本账不证明产品质量变好,也不打算证明。它只说清楚钱和人各自花在了哪里。
要从这本账里留一句话,就留第一句:钱花在想清楚之前,行数落在想清楚之后。想清楚这件事,没法外包。